ترجمه PDF اسکنشده با حفظ جدولها؛ مسیر OCR، ترجمه و بازبینی
مسیر ترجمه PDF اسکنشده دارای جدول: تشخیص متن با OCR، بازسازی سلولها و کنترل عددها؛ همراه PDF آموزشی، خروجی خام OCR و فایل Word ترجمهشده.
برای ترجمه PDF اسکنشده دارای جدول، ابتدا باید نوشتههای تصویر با OCR به متن تبدیل شوند؛ سپس ارتباط هر مقدار با سطر، ستون و واحد آن کنترل شود. خروجی OCR را مستقیما ترجمه نکنید مگر مطمئن شده باشید چیزی حذف یا جابهجا نشده است. حفظ ظاهر صفحه و داشتن جدول قابل ویرایش دو نتیجه متفاوتاند.
در این راهنما یک PDF آموزشی تصویری، متن خام حاصل از OCR واقعی و فایل Word شامل جدول مبدا و ترجمه فارسی را دریافت میکنید. هدف، نشان دادن یک مسیر قابل بررسی است؛ حفظ خودکار و بینقص قالب همه PDFها وعده داده نمیشود.
از کجا بفهمیم PDF به OCR نیاز دارد؟
یک کلمه را در PDF انتخاب و در ویرایشگر متن جایگذاری کنید. اگر فقط کل صفحه به شکل تصویر انتخاب میشود و جستجوی عبارت هم نتیجه ندارد، احتمالا فایل تصویری است. اگر متن انتخاب میشود اما خروجی نامفهوم یا ترتیب آن نادرست است، ممکن است لایه متن یا ساختار استخراج مشکل داشته باشد. این وضعیت با نبود کامل لایه متن یکی نیست.
فایلهای ترکیبی را صفحه به صفحه بررسی کنید؛ وجود متن قابل انتخاب در صفحه اول به معنی متنی بودن همه جدولها نیست. روی PDF رمزدار هم ابتدا مجوز دسترسی و امکان استخراج را از صاحب فایل بگیرید.
بسته نمونه: مبدا، OCR و ترجمه
PDF اسکنشده جدول آموزشی: یک صفحه تصویری با وضوح 300 dpi، بدون لایه متن؛ دادههای آن ساختگی و آموزشیاند و به سفارش واقعی مربوط نیستند.
خروجی خام OCR با قالب TXT: نتیجه واقعی Tesseract 4.1.1 با زبان eng و حالت psm 3؛ متن خام برای نمایش نتیجه ابزار دستکاری نشده است.
فایل Word جدول مبدا بازبینیشده و ترجمه فارسی: جدولها به صورت دستی بازسازی و ردیف به ردیف با تصویر تطبیق داده شدهاند. این فایل، خروجی خودکار و دستنخورده OCR نیست.
نمونه شامل سه ردیف قطعه و پنج ستون است. در اجرای این نمونه، OCR هر سه کد و نه مقدار عددی جدول را درست خواند؛ اما فایل TXT ساختار سلول قابل ویرایش ندارد. پس برای ساخت Word، بازسازی جدول و کنترل ارتباط ستونها همچنان لازم بود. این نتیجه فقط درباره همین نمونه تمیز است و نرخ دقت ابزار روی اسناد دیگر را نشان نمیدهد.
مسیر پیشنهادی در هفت مرحله
۱. خروجی لازم را مشخص کنید
اگر قرار است عددها یا متن بعدا ویرایش شوند، جدول Word یا Excel بخواهید. اگر فقط خروجی نهایی برای مطالعه لازم است، PDF میتواند مناسب باشد؛ ولی حتی در PDF نهایی باید متن و ارتباط سلولها کنترل شده باشد. پیش از شروع، محدوده صفحات، زبان ترجمه و نیاز به ترجمه توضیح شکلها و پاورقیها را بنویسید.
۲. تصویر قابل خواندن آماده کنید
کجی صفحه، سایه، لبه بریده و تصویر تار، تشخیص متن را دشوار میکنند. صفحه را صاف و کامل بگیرید و اعشار و واحدها را در اندازه واقعی بخوانید. مستندات Tesseract وضوح حدود 300 dpi یا بیشتر را برای ورودی مناسب مطرح میکند؛ بزرگ کردن یک تصویر تار جزئیات از دست رفته را برنمیگرداند. نمونه ما از ابتدا با همین وضوح ساخته شده است.
۳. OCR را با زبان مبدا اجرا کنید
در راهنمای جاری Acrobat، ابزار Scan & OCR و فرمان Recognize Text برای شناسایی متن سند اسکنشده معرفی شده است. محدوده صفحات و زبان سند را تعیین و نتیجه را با نام تازه ذخیره کنید. دسترسی به گزینهها به نسخه و امکانات نصبشده بستگی دارد؛ پشتیبانی فارسی را از روی وجود زبان موردنیاز در همان ابزار بررسی کنید.
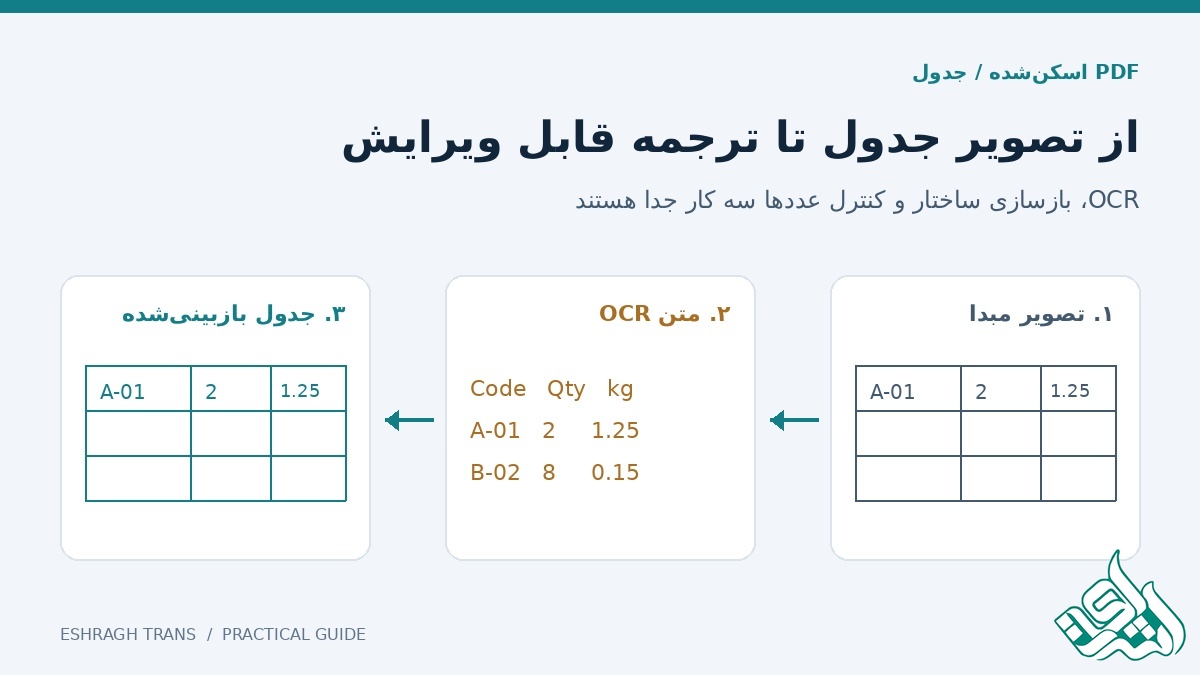
نمونه این صفحه با Acrobat پردازش نشده است. برای بازتولید نتیجه آن، تصویر صفحه به Tesseract داده شد و خروجی متن گرفته شد. Tesseract در این مسیر مستقیما PDF را به جدول Word ترجمه نمیکند؛ استخراج متن، بازسازی جدول و ترجمه مرحلههای جدا هستند.
۴. ساختار جدول را پیش از ترجمه بازسازی کنید
تعداد سطرها و ستونها را از تصویر مبدا بشمارید. مشخص کنید سربرگ چندسطری، سلول ادغامشده، پانویس یا ردیف جمع دارید یا نه. خروجی متن ساده ممکن است فاصلهها را نگه دارد ولی مرز واقعی سلولها را ثبت نکرده باشد. جدول مقصد را با همان رابطه دادهها بسازید و سپس مقدارها را منتقل کنید.
بازکردن PDF در Word هم تضمین حفظ جدول نیست. طبق توضیح مایکروسافت، ساختار ذخیرهشده در PDF همیشه شامل رابطه سلولهای جدول نیست و Word باید چیدمان را تفسیر کند. اگر تبدیل آماده نتیجه خوبی نداد، بازسازی یک جدول کوچک میتواند روشنتر از اصلاح متنهای پراکنده باشد.
۵. متن مبدا و عددها را بازبینی کنید
پیش از ترجمه، کدها، اعشار، منفیها، درصدها و واحدها را با تصویر تطبیق دهید. «1» و «I»، «0» و «O» یا نقطه اعشار ممکن است در OCR اشتباه خوانده شوند؛ در نمونه حاضر چنین خطای عددی مشاهده نشد. اگر کاراکتری در اصل هم خوانا نیست، حدس نزنید و نسخه واضحتر بخواهید.
۶. فقط بخشهای لازم را ترجمه کنید
عنوان جدول، شرحها، سربرگ و یادداشتها را ترجمه کنید. برای کد قطعه، نام محصول، عدد و واحد از ابتدا قاعده بگذارید. در نمونه ما کدها، مقدارها و واحد kg عینا حفظ شدهاند؛ تبدیل واحد یا تغییر تعداد اعشار انجام نشده است. برای اصطلاحهای فنی یک معادل ثابت انتخاب کنید.
۷. نسخه نهایی را با تصویر مبدا تطبیق دهید
در جدول فارسی، راستبهچپ شدن صفحه نباید باعث شود مقدار یک ستون زیر عنوان ستون دیگری قرار بگیرد. هر ردیف را با کد آن پیدا و همه مقدارها را کنترل کنید. بعد از خروجی PDF نیز یک بار نسخه نهایی را باز کنید تا متن بریده، ردیف پنهان یا جابهجایی صفحه رخ نداده باشد.
مقایسه واقعی یک ردیف در سه مرحله
مرحله | داده ردیف A-01 | چه چیزی کنترل شد؟ |
|---|---|---|
تصویر PDF مبدا | A-01 / Sensor bracket / 2 / 1.25 / 2.50 | کد، شرح، تعداد، جرم واحد و جرم کل |
متن خام OCR | A-01 Sensor bracket 2 1.25 2.50 | همه مقدارها خوانده شدهاند؛ در TXT سلول مستقل نداریم. |
جدول ترجمهشده | A-01 / براکت حسگر / 2 / 1.25 / 2.50 | فقط شرح ترجمه شده و نسبت مقدارها به ستون محفوظ است. |
در نمونه، جرم کل سه ردیف برابر 2.50 + 1.20 + 6.00 = 9.70 kg است. جمعزدن یک کنترل کمکی است؛ حتی اگر جمع درست باشد، هنوز ممکن است دو مقدار جابهجا شده باشند. کنترل ردیف به ردیف را با بررسی جمع جایگزین نکنید.
چکلیست تحویل جدول ترجمهشده
همه صفحهها و جدولهای محدوده سفارش در خروجی حضور دارند.
تعداد ردیف و ستون، سربرگ، سلول ادغامشده و پانویس با مبدا تطبیق داده شدهاند.
کدها، مقدارها، اعشار، درصدها و واحدها تغییر ناخواسته ندارند.
اگر واحد یا شیوه نمایش عدد تغییر کرده، قاعده و تبدیل آن مستند است.
جدول Word یا Excel واقعا سلول قابل ویرایش دارد و صرفا تصویر جدول نیست.
چینش فارسی و متن ترکیبی، عرض ستون و شکست صفحه در فایل نهایی بررسی شدهاند.
برای سفارش ترجمه PDF چه چیزی بفرستیم؟
در مسیر ترجمه تخصصی متن، فایل کامل، محدوده صفحات، زبان مبدا و مقصد، موضوع و قالب خروجی را مشخص کنید. اگر جدول قابل ویرایش لازم دارید، همین خواسته را صریح بنویسید و یک صفحه نماینده از جدولهای پیچیده را برای بررسی معرفی کنید. برای متن پژوهشی، صفحه ترجمه تخصصی مقاله نیز مسیر مرتبط است.
هزینه ترجمه متن و کار لازم برای استخراج یا بازسازی فایل باید بر اساس فایل واقعی روشن شود. شمار کلمات OCR پیش از بازبینی ممکن است به دلیل حذف یا تکرار متن با محتوای واقعی متفاوت باشد؛ از تعداد صفحه یا اندازه فایل بهتنهایی قیمت قطعی استنتاج نکنید. برای فایل محرمانه، پیش از بارگذاری در هر ابزار آنلاین، مجوز و شرایط نگهداری داده را بررسی کنید.
منابع و تاریخ بررسی
بررسی منابع و نمونه: ۱۸ نوامبر ۲۰۲۶. راهنمای OCR در Acrobat در helpx.adobe.com/acrobat/desktop/create-documents/scan-documents-to-pdfs/recognize-text.html؛ راهنمای مایکروسافت در support.microsoft.com/en-us/word/opening-pdfs-in-word؛ کیفیت OCR در tesseract-ocr.github.io/tessdoc/ImproveQuality.html و اجرای خط فرمان در tesseract-ocr.github.io/tessdoc/Command-Line-Usage.html. تصویر، جدول و فایلهای تمرینی برای همین مقاله تولید شدهاند.