رفع حروف ناخوانای زیرنویس فارسی؛ راهنمای Encoding و UTF‑8 با فایل نمونه
زیرنویس فارسی ناخواناست؟ تفاوت Encoding اشتباه، فونت و متن خراب را بشناسید؛ با سه فایل SRT آموزشی، تبدیل به UTF-8 و حفظ زمانها را بررسی کنید.
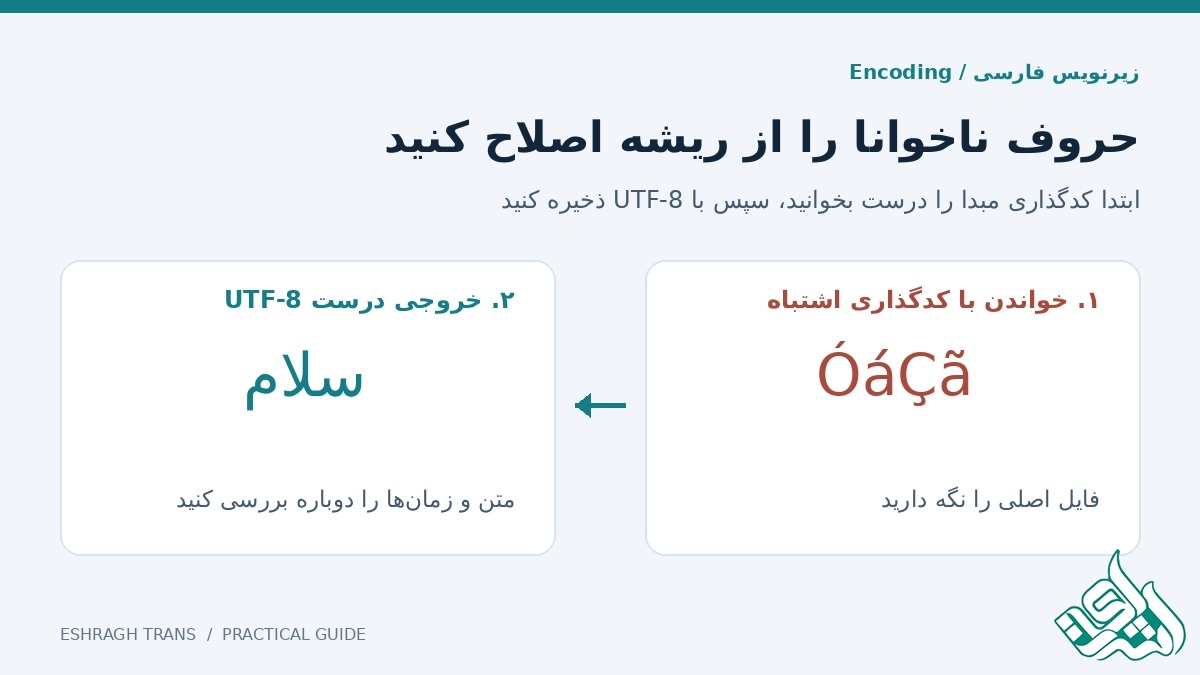
اگر زیرنویس فارسی به شکل حروفی مثل «ÓáÇã» یا «Ø…» دیده میشود، اول فایل اصلی را نگه دارید و کدگذاری آن را بررسی کنید. راه درست این است که متن با کدگذاری مبدا درست خوانده شود و بعد با UTF-8 ذخیره شود. انتخاب UTF-8 هنگام ذخیره یک متن از قبل خراب، بهتنهایی کلمهها را برنمیگرداند.
این راهنما برای زیرنویس متنی، بهویژه SRT است. زیرنویس چسبیده به تصویر و فایلهای تصویری مسیر دیگری دارند. در ادامه سه فایل آموزشی قابل دانلود داریم تا تفاوت «اشتباه خواندن فایل» و «ذخیره شدن متن خراب» را ببینید.
ابتدا نوع مشکل را تشخیص دهید
نشانه | چه چیزی را بررسی کنیم؟ | قدم اول |
|---|---|---|
به جای فارسی، حروف لاتین نامفهوم میبینید | احتمال خواندن بایتها با کدگذاری نامناسب | فایل اصلی را بدون ذخیره دوباره با Encoding مبدا باز کنید. |
در ویرایشگر درست است، در پخشکننده خراب است | کدگذاری یا قلم پخشکننده | فایل UTF-8 را دوباره بارگذاری و قلم دارای حروف فارسی انتخاب کنید. |
مربع یا جای خالی به جای بعضی حروف است | احتمال نبود شکل حروف در قلم | همان فایل را با قلم دیگری بررسی کنید؛ این نشانه بهتنهایی خرابی Encoding را ثابت نمیکند. |
حروف خوانا هستند ولی عدد یا پرانتز جابهجاست | جهت متن و ترکیب فارسی و انگلیسی | تنظیم راستبهچپ و نمایش متن ترکیبی را کنترل کنید. |
متن درست است ولی زودتر یا دیرتر میآید | زمانبندی زیرنویس | تغییر Encoding این مشکل را برطرف نمیکند. |
دانلود فایلهای نمونه و مقایسه نتیجه
هر سه نمونه را برای همین آموزش ساختهایم؛ متعلق به فیلم یا مشتری نیستند. هر فایل سه قطعه در بازه ۱ تا ۱۲ ثانیه دارد. شماره قطعهها و زمانها در همه نسخهها یکسان است.
دانلود بسته ZIP شامل سه فایل SRT و راهنمای فارسی. بسته را از حالت فشرده خارج کنید و فایل موردنظر را باز کنید:
n001-legacy-windows1256.srt؛ فایل مبدا با کدگذاری Windows-1256: متن در بایتها سالم است، اما با انتخاب کدگذاری اشتباه ناخوانا میشود. ممکن است نرمافزار شما آن را خودکار درست تشخیص دهد؛ در این صورت خرابی ظاهری نمیبینید.
n001-fixed-utf8.srt؛ فایل اصلاحشده با کدگذاری UTF-8: همان متن و زمانبندی با کدگذاری جدید ذخیره شده است.
n001-mojibake-saved-utf8.srt؛ متن خراب ذخیرهشده با UTF-8: برای نشان دادن اینکه برچسب UTF-8 بهتنهایی سلامت متن را ثابت نمیکند.
برای سازگاری نمونه قدیمی، نویسه «ي» به کار رفته است. تبدیل کدگذاری، همان نویسهها را حفظ میکند؛ تبدیل «ي» به «ی» و یکسانسازی نگارش کار جداگانهای است. این تفاوت را با خرابی فایل اشتباه نگیرید.
تبدیل زیرنویس قدیمی به UTF-8 در شش قدم
یک کپی از فایل اصلی نگه دارید. روی تنها نسخه خودتان ذخیره نکنید. برای خروجی، نام تازهای مانند subtitle-utf8.srt انتخاب کنید.
فایل را با انتخاب دستی کدگذاری وارد کنید. در راهنمای رسمی Subtitle Edit، گزینه File → Import subtitle with manual chosen encoding برای این کار معرفی شده است. نام و محل گزینه ممکن است با نسخه یا زبان برنامه فرق کند؛ منظور انتخاب Encoding هنگام خواندن فایل است.
کدگذاری مبدا را از روی پیشنمایش کنترل کنید. برای فایل legacy همین صفحه، Windows-1256 انتخاب درست است. آن را برای همه زیرنویسهای فارسی نسخه ثابت ندانید؛ فایل شما ممکن است از ابتدا UTF-8 یا کدگذاری دیگری داشته باشد.
چند سطر را بخوانید. فقط اولین کلمه کافی نیست. حروف فارسی، نشانهها، عددها و عبارت انگلیسی را در چند بخش بررسی کنید. تا متن خوانا نشده، مرحله ذخیره را انجام ندهید.
خروجی را با قالب SubRip و Encoding برابر UTF-8 ذخیره کنید. پسوند نهایی باید .srt بماند. تغییر نام پسوند از txt به srt هیچ تبدیلی در کدگذاری انجام نمیدهد. اگر برنامه گزینه BOM دارد، انتخاب را با مقصد سازگار کنید؛ برای نمونه این صفحه خروجی UTF-8 بدون BOM ساخته شده است.
فایل خروجی را ببندید و دوباره باز کنید. سپس آن را در پخشکننده مقصد بارگذاری کنید. تعداد قطعهها و زمان شروع و پایان باید با مبدا برابر باشد. نسخه قدیمی زیرنویس را از فهرست پخش کنار بگذارید تا ناخواسته همان فایل قبلی را نبینید.
مسیر منوی بالا بر اساس مستندات سازنده است. در بررسی نمونههای این صفحه، تبدیل بایتها و برابری متن و زمانها مستقلا کنترل شده است؛ این بررسی به معنی آزمایش همه نسخههای Subtitle Edit، تلویزیونها یا پخشکنندههای موبایل نیست.
اگر فایل UTF-8 است ولی هنوز حروف عجیب دارد
فایل سوم بسته عمدا چنین وضعیتی دارد: متن سالم ابتدا با کدگذاری اشتباه تفسیر شده و همان نتیجه دوباره ذخیره شده است. این فایل از نظر ساختار بایت، UTF-8 معتبر است؛ اما متن آن فارسی درست نیست. ذخیره مجدد با UTF-8 فقط همان حروف نامفهوم را نگه میدارد.
مطمئنترین مسیر، بازگشت به فایل اصلی و خواندن درست آن است. اگر اصل فایل را ندارید، گاهی با دانستن زنجیره دقیق تبدیل میتوان متن را بازیابی کرد. این کار باید روی کپی و با تطبیق نتیجه انجام شود؛ یک تبدیل حدسی برای همه فایلها راهحل مطمئنی نیست.
اگر نویسهها واقعا با علامت سؤال «?» یا نویسه جایگزین «�» ذخیره شده باشند، ممکن است بخشی از اطلاعات از بین رفته باشد. صرف دیدن این علامت در پخشکننده هنوز اتلاف اطلاعات را ثابت نمیکند؛ ابتدا اصل فایل را در ویرایشگر مناسب باز کنید. در صورت از دست رفتن بایتهای اصلی، ترجمه یا نسخه سالم مبدا لازم میشود.
کنترل نهایی پیش از ارسال زیرنویس
متن فارسی در فایل بسته و دوباره بازشده خواناست؛ فقط ظاهر یک پنجره را ملاک قرار ندادهاید.
فایل با پسوند واقعی .srt ذخیره شده و به .srt.txt تبدیل نشده است.
شماره قطعهها، زمانها و خط خالی جداکننده در تبدیل حذف نشدهاند.
یک سطر دارای عدد، پرانتز یا عبارت انگلیسی در مقصد واقعی کنترل شده است.
برای بارگذاری در یوتیوب، فایل SRT ساده با UTF-8 آماده است؛ قالب SRT پایه در آن مسیر اطلاعات ظاهری پیشرفته را حفظ نمیکند.
چه زمانی اصلاح فایل کافی نیست؟
اگر فقط نمایش حروف مشکل دارد، از همین بررسی کدگذاری شروع کنید. اگر معنی ترجمه نادرست است، بخشی از گفتار جا افتاده یا زمانبندی با فیلم هماهنگ نیست، دامنه کار را جدا مشخص کنید. در راهنمای ترجمه فیلم و ساخت زیرنویس مسیر کلی را توضیح دادهایم.
برای بررسی و سفارش ترجمه تخصصی زیرنویس، ویدئو، فایل اصلی زیرنویس، زبان مبدا و مقصد و نوع خروجی موردنیاز را بفرستید. اصلاح Encoding، ترجمه متن و هماهنگسازی زمان سه نیاز متفاوتاند؛ هزینه و زمان انجام باید بر اساس فایل و دامنه واقعی کار مشخص شود.
منابع و تاریخ بررسی
بررسی منابع و نمونهها: ۱۸ نوامبر ۲۰۲۶. راهنمای رسمی Subtitle Edit در nikse.dk/se/؛ راهنمای قالبهای زیرنویس YouTube در support.google.com/youtube/answer/2734698؛ مستندات کدگذاری Python در docs.python.org/3/library/codecs.html. فایلها و تصویر آموزشی این صفحه برای همین راهنما تولید شدهاند.